Simulationsausdrücke
Diese Referenz beschreibt die Ausdruckssprache, die überall in den Simulationseigenschaften verwendet wird – die Eingabemodi, Datentypen, Operatoren und jede integrierte Funktion. Ein Ausdruck ist eine arithmetische oder logische Anweisung, die während des Simulationslaufs einen Wert berechnet; er kann Variablen, eigene Funktionen und die unten aufgeführten integrierten Funktionen verwenden.
So geben Sie einen Ausdruck ein
Jedes Ausdrucksfeld hat einen Modus, den Sie mit der Dropdown-Liste an seinem rechten Rand umschalten:

| Modus | Verwendung |
|---|---|
| Konstant | Ein einfacher Wert – eine Zahl oder wahr/falsch. Der schnellste Weg, festzulegen, dass eine Aufgabe genau 1 Minute dauert. |
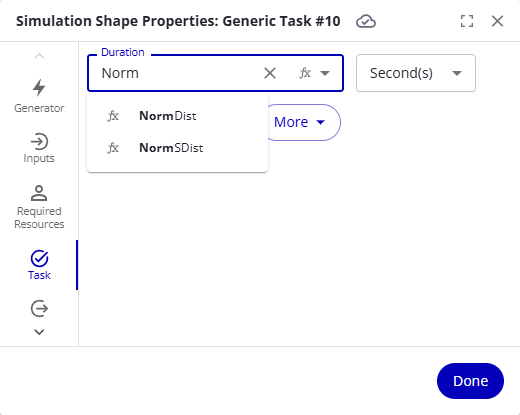
| Ausdruck | Die vollständige Sprache: Variablen, Funktionen, Operatoren. Beim Tippen öffnet sich die Autovervollständigung mit den Variablen Ihres Modells und den integrierten Funktionen. Wenn Sie auf einen Vorschlag zeigen, sehen Sie, was er tut, und wenn Sie die Klammern einer Funktion eingeben, sehen Sie Namen und Reihenfolge ihrer Parameter. |
| Zwischen (Gleichmäßig) | Zwei Grenzen; jede Auswertung liefert einen gleichverteilten Wert zwischen ihnen. |
| Zwischen (Normal) | Zwei Grenzen; jede Auswertung liefert einen normalverteilten Wert zwischen ihnen – die meisten Ergebnisse nahe der Mitte, wenige an den Rändern. |
| Daten anpassen | Leitet eine Verteilung aus Daten ab, die Sie bereitstellen: Wählen Sie eine Spalte, und eine Verteilung (Uniform, Normal, LogNormal, Exponential oder Weibull) wird anhand des niedrigsten AD Score automatisch ausgewählt. Die Alternativen werden aufgelistet, damit Sie die Auswahl bestätigen oder ändern können. |
| In Szenariovariable konvertieren | Ersetzt die Konstante durch eine neue Szenariovariable, sodass der Wert pro Szenario und mit Alle Szenarios ausführen variieren kann. |
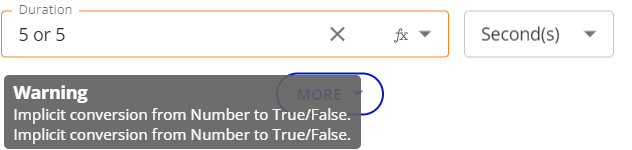
Ausdrücke werden geprüft, wenn Sie das Feld verlassen. Eine Warning bedeutet, dass der Ausdruck zwar ausgewertet werden kann, aber möglicherweise etwas Unerwartetes tut; ein Error bedeutet, dass er nicht ausgeführt werden kann, und die Simulation startet erst, wenn Sie ihn korrigieren.
Datentypen
| Typ | Werte |
|---|---|
| Nummer | Mit oder ohne Dezimalstellen: 5, 10.25. |
| Text | Alles in Anführungszeichen: "High priority". |
| Wahr/falsch | true oder false. |
| Tabelle | Eine Tabellenvariable; eine Zelle lesen Sie als Variable[Row, Column]. |
Operatoren
Operationen werden in der Reihenfolge dieser Tabelle ausgewertet; mit Klammern ändern Sie die Reihenfolge.
| Operation | Beschreibung |
|---|---|
-x | Negiert x. |
x ^ y | x hoch y. |
x * y | Multiplikation. |
x / y | Division. |
x % y | Rest von x geteilt durch y. |
x + y | Addition. |
x - y | Subtraktion. |
x <= y, x < y, x >= y, x > y | Numerischer Vergleich; wahr oder falsch. |
x != y | Wahr, wenn x und y sich unterscheiden. |
x = y, x == y | Wahr, wenn x und y gleich sind. |
!x | Macht aus wahr falsch und aus falsch wahr. |
x and y | Wahr, wenn beide wahr sind. |
x or y | Wahr, außer wenn beide falsch sind. |
if x then y else z | y, wenn x wahr ist, sonst z. |
x ? y : z | Dieselbe Bedingung in Kurzform. |
Zeitfunktionen
| Funktion | Beschreibung | Syntax |
|---|---|---|
| ElapsedTime | Liefert die seit dem Start der Simulation vergangene Zeit in Sekunden. Nach vier simulierten Stunden gilt ElapsedTime() = 14400. | ElapsedTime() |
| TotalTime | Liefert die gesamte Laufzeit der Simulation in Sekunden. Bei einem vierstündigen Lauf gilt TotalTime() = 14400. Löst einen Fehler aus, wenn der Lauf keine festgelegte Zeit hat (zum Beispiel, wenn er nach abgeschlossenen Fällen endet). | TotalTime() |
Logische Funktionen
| Funktion | Beschreibung | Syntax |
|---|---|---|
| If | Liefert einen Wert abhängig von einem Test. Ist Test wahr, wird der Then-Wert geliefert, sonst der Else-Wert. Ein numerischer Test gilt als wahr, wenn er ungleich null ist; ein Text-Test gilt als wahr, wenn er nicht leer ist. Zusätzliche Parameterpaare wirken als ElseIf-Zweige: Ist der erste Test falsch, wird der nächste Test ausgewertet und so weiter. | If(Test,Then,Else) · If(Test,Then,ElseIfTest,Then,…,Else) |
| IsEmpty | Liefert 1, wenn String "" ist, sonst 0. | IsEmpty(String) |
| IsNum | Liefert 1, wenn Value numerisch ist, sonst 0. | IsNum(Value) |
| Select | Liefert einen Wert nach ganzzahligem Index: 0 liefert Case0, 1 liefert Case1 und so weiter. Außerhalb des Bereichs wird Default geliefert. | Select(CaseNum,Default,Case0,…CaseN) |
| Switch | Vergleicht SwitchValue mit jedem Value und liefert das zugehörige Result des ersten Treffers oder Default, wenn es keinen Treffer gibt. | Switch(SwitchValue,Default,Value1,Result1,…ValueN,ResultN) |
Numerische Funktionen
| Funktion | Beschreibung | Syntax |
|---|---|---|
| Abs | Der Absolutwert: Abs(-4) = 4. | Abs(Num) |
| BatchCount | Die Zahl der Fälle im aufrufenden Stapelfall oder 0, wenn der aufrufende Fall kein Stapel ist. Ein Stapel kann andere Stapel enthalten; das optionale Depth legt fest, wie viele zusätzliche Stapelebenen mitgezählt werden – fehlt es oder ist es 0, wird nur die erste Ebene gezählt. Bei einem Stapel mit zwei Stapeln zu je 3 Fällen gilt BatchCount() = 2 und BatchCount(1) = 6. | BatchCount(Depth) |
| Ceiling | Rundet auf eine ganze Zahl auf: Ceiling(2.5) = 3, Ceiling(-4.37) = -4. | Ceiling(Num) |
| Exp | e (2,71828…) hoch Num: Exp(1) = 2.71828. | Exp(Num) |
| Floor | Rundet auf eine ganze Zahl ab: Floor(4.3) = 4, Floor(-5.4) = -6. | Floor(Num) |
| Ln | Der natürliche Logarithmus (Umkehrung von Exp); Num muss positiv sein. Ln(Exp(4)) = 4. | Ln(Num) |
| Log10 | Der Logarithmus zur Basis 10; Num muss positiv sein. | Log10(Num) |
| Max | Das größere der beiden Argumente: Max(4,9) = 9. | Max(Num1, Num2) |
| Min | Das kleinere der beiden Argumente: Min(4,9) = 4. | Min(Num1, Num2) |
| Round | Rundet auf NumDigits Dezimalstellen; 0 rundet auf eine ganze Zahl, ein negativer Wert rundet links vom Dezimaltrennzeichen: Round(3.45, 1) = 3.5, Round(11.5,-1) = 10. | Round(Num, NumDigits) |
| Sqrt | Die positive Quadratwurzel; Num muss positiv sein. | Sqrt(Num) |
| Trunc | Rundet in Richtung null auf NumDigits Dezimalstellen: Trunc(9.765,2) = 9.76, Trunc(-9.765,2) = -9.76. | Trunc(Num, NumDigits) |
Statistische Funktionen
Diese Funktionen liefern Zufallswerte aus Verteilungen – der Kern realistischer Dauern und Entscheidungen.
| Funktion | Beschreibung | Syntax |
|---|---|---|
| BernoulliDist | Liefert 1 oder 0; das Argument gibt an, wie oft 1 zurückkommt. BernoulliDist(0.7) liefert in etwa 70 % der Fälle 1. | BernoulliDist(Probability) |
| BetaDist | Die kumulative Beta-Wahrscheinlichkeitsdichte zwischen Min und Max; häufig verwendet, um die Schwankung eines Prozentsatzes über Stichproben hinweg zu untersuchen. | BetaDist(A,B,Min,Max) |
| Between | Eine gleichverteilte Zahl zwischen Min und Max, beide einschließlich – jeder Wert ist gleich wahrscheinlich. | Between(Min,Max) |
| BetweenNorm | Ein normalverteilter Wert zwischen Min und Max – Mittelwert und Abweichung werden aus den Grenzen abgeleitet, und das Ergebnis bleibt immer innerhalb der Grenzen. BetweenNorm(10,20) liegt meist nahe 15, selten bei 10 oder 20. | BetweenNorm(Min,Max) |
| BinomDist | Bildet das Ziehen aus einem Vorrat von N Elementen nach, von denen jedes mit der angegebenen Wahrscheinlichkeit erfolgreich gezogen wird. | BinomDist(N,Probability) |
| CustomDist | Eine eigene Verteilung über Intervalle zwischen 0 und 100. Der erste Parameter ist der Wert des letzten Intervalls; die übrigen sind Paare aus Intervall-Obergrenze und Wert. CustomDist(5, 25, 20, 75, 10): 0–25 → 20, 25–75 → 10, 75–100 → 5. | CustomDist(LastValue, Bound1, Value1, …BoundN, ValueN) |
| ErlangDist | Zufallswerte, bei denen N der Mittelwert und B die Varianz ist; beide müssen größer als null sein, und N ist eine ganze Zahl. Ein Spezialfall der Gammaverteilung. | ErlangDist(N,B) |
| ExponDist | Ein Wert aus der Exponentialverteilung mit dem angegebenen Mean – die Werte häufen sich nahe dem Mittelwert, mit gelegentlichen großen Ausreißern. Berechnet als -ln(1-x) * Mean für ein gleichverteiltes zufälliges x. | ExponDist(Mean) |
| GammaDist | Zufallswerte aus der Gammaverteilung mit den Formparametern A und B. | GammaDist(A,B) |
| LogNormDist | Die logarithmische Normalverteilung; die Parameter sind der Mittelwert und die Varianz (Abweichung zum Quadrat). | LogNormDist(Mean,Variance) |
| NormDist | Eine normalverteilte Zufallsvariable mit dem angegebenen Mittelwert und der angegebenen Standardabweichung. | NormDist(Mean,Deviation) |
| NormSDist | Eine standardnormalverteilte Zufallsvariable – Mittelwert 0, Standardabweichung 1. Nimmt keine Argumente. | NormSDist() |
| PercentTrue | Liefert in Num % der Fälle wahr: PercentTrue(95) ist in 95 % der Fälle wahr. | PercentTrue(Num) |
| PercentFalse | Liefert in Num % der Fälle falsch: PercentFalse(95) ist in 95 % der Fälle falsch. | PercentFalse(Num) |
| PoissonDist | Die Grenzform der Binomialverteilung; exponentielle Zwischenankunftszeiten entsprechen Poisson-Ankünften. | PoissonDist(Mean) |
| ProportionalDist | Liefert den Index i mit der Wahrscheinlichkeit Num(i) geteilt durch die Summe aller Argumente (bis zu 12 Argumente, alle ≥ 0); liefert -1, wenn die Summe 0 ist. | ProportionalDist(Num0,Num1,…) |
| Random | Eine gleichverteilte zufällige reelle Zahl zwischen 0 und 1. | Random() |
| TriangleDist | Eine dreieckförmige Verteilung: Min und Max begrenzen das Ergebnis, Mode ist der wahrscheinlichste Wert. | TriangleDist(Min,Max,Mode) |
| WeibullDist | Die Weibull-Verteilung mit den Parametern A und B (beide größer als 0); typischerweise für Zuverlässigkeitsanalysen verwendet. | WeibullDist(A,B) |
Zeichenkettenfunktionen
| Funktion | Beschreibung | Syntax |
|---|---|---|
| Compare | Vergleich mit Beachtung der Groß-/Kleinschreibung: -1, wenn String1 kleiner als String2 ist, 0 bei Gleichheit, 1, wenn größer. | Compare(String1, String2) |
| CompareNoCase | Die Version von Compare ohne Beachtung der Groß-/Kleinschreibung. | CompareNoCase(String1, String2) |
| Concat | Verbindet zwei Zeichenketten: Concat("Hello", "World") = "HelloWorld". | Concat(String1, String2) |
| CropLeft | Sucht von links nach rechts nach dem einzelnen Zeichen CropString und löscht alles bis einschließlich dieses Zeichens; liefert String unverändert, wenn es nicht gefunden wird. | CropLeft(String, CropString) |
| CropRight | Sucht von rechts nach links nach dem einzelnen Zeichen CropString und löscht ab diesem Zeichen bis zum Ende; liefert String unverändert, wenn es nicht gefunden wird. | CropRight(String, CropString) |
| Delete | Löscht höchstens Count Zeichen ab Index. | Delete(String, Index[, Count = 1]) |
| Find | Suche nach SearchString ab Index mit Beachtung der Groß-/Kleinschreibung; liefert den gefundenen Index oder -1. | Find(String, SearchString[, Index = 0]) |
| FindNoCase | Die Version von Find ohne Beachtung der Groß-/Kleinschreibung. | FindNoCase(String, SearchString[, Index = 0]) |
| FindOneOf | Liefert den Index des ersten Zeichens von String, das auch in FindString vorkommt, oder -1. | FindOneOf(String, FindString) |
| GetLength | Die Länge von String. | GetLength(String) |
| Insert | Fügt InsertionString an Index in String ein. | Insert(String, Index, InsertionString) |
| LeftCount | Die Count Zeichen ganz links; die ganze Zeichenkette, wenn Count ihre Länge übersteigt. | LeftCount(String, Count) |
| LeftIndexString | Die Zeichen links vom ersten Vorkommen von IndexString; String unverändert, wenn es nicht gefunden wird. | LeftIndexString(String, IndexString) |
| MakeLower | Wandelt in Kleinbuchstaben um. | MakeLower(String) |
| MakeUpper | Wandelt in Großbuchstaben um. | MakeUpper(String) |
| MakeReverse | Kehrt die Reihenfolge der Zeichen um. | MakeReverse(String) |
| MidIndex | Höchstens Count Zeichen ab Index. | MidIndex(String, Index[, Count]) |
| MidIndexString | Höchstens Count Zeichen ab dem ersten Vorkommen von IndexString; die leere Zeichenkette, wenn es nicht gefunden wird. | MidIndexString(String, IndexString[, Count]) |
| Replace | Ersetzt jedes OldString durch NewString, mit Beachtung der Groß-/Kleinschreibung. | Replace(String, OldString, NewString) |
| ReplaceNoCase | Die Version von Replace ohne Beachtung der Groß-/Kleinschreibung. | ReplaceNoCase(String, OldString, NewString) |
| ReverseFind | Sucht von rechts nach links nach dem einzelnen Zeichen SearchString; liefert seinen Index oder -1. | ReverseFind(String, SearchString) |
| RightCount | Die Count Zeichen ganz rechts. | RightCount(String, Count) |
| RightIndexString | Die Zeichen rechts vom ersten Vorkommen von IndexString; die leere Zeichenkette, wenn es nicht gefunden wird. | RightIndexString(String, IndexString) |
| SetAt | Überschreibt String ab Index mit SetString; das Ergebnis kann länger als String sein. | SetAt(String, Index, SetString) |
| SpanExcluding | Die führenden Zeichen von String bis zum (aber ohne das) erste Zeichen, das in SpanString vorkommt; String unverändert, wenn keines gefunden wird. | SpanExcluding(String, SpanString) |
| SpanIncluding | Die führenden Zeichen von String, die in SpanString vorkommen, bis zum ersten, das nicht vorkommt; die leere Zeichenkette, wenn schon das erste Zeichen nicht vorkommt. | SpanIncluding(String, SpanString) |
| ToNumber | Wandelt eine Zeichenkette in eine Zahl um; führende und nachgestellte Leerzeichen werden ignoriert, und die leere Zeichenkette wird zu 0. Zahlen bleiben unverändert. | ToNumber(Value) |
| TrimLeft | Entfernt führende Leerzeichen. | TrimLeft(String) |
| TrimRight | Entfernt nachgestellte Leerzeichen. | TrimRight(String) |
| ValueToString | Wandelt einen Wert in eine Zeichenkette um; Zeichenketten bleiben unverändert. | ValueToString(Value) |
Hinweise / Einschränkungen
- Die Liste der Autovervollständigung ist der maßgebliche Funktionskatalog für Ihr Release: Alles, was sie anbietet, ist verfügbar, ihre Tooltips entsprechen den Beschreibungen oben, und beim Tippen innerhalb der Klammern einer Funktion sehen Sie Namen und Position jedes Parameters.
- Ausdrücke von Bewertungsfunktionen werden nach dem Ende des Laufs ausgewertet und können daher zusätzlich die Statistiken des Laufs über den Geltungsbereich
Statisticslesen.

Verwandte Themen
- Simulationseigenschaften – Variablen, eigene Funktionen, Szenarien
- Simulationseigenschaften von Symbolen – wo Ausdrücke verwendet werden
- Tabellenvariablen verwenden